Atlas 装上轮子 — 全文中文译文
| 项 | 值 |
|---|---|
| 对应原文 | ../sources/2026-11-10-atlas-on-a-roll-source.md |
| 原文链接 | https://bostondynamics.com/blog/atlas-on-a-roll/ |
| 抓取日期 | 2026-11-10 |
| 整理 | 小 Q · 2026-11-10 |
| 性质 | 全文逐段对译,不做观点分析、不预置提问 |
译法约定:actuator 统一译「执行器」;policy 译「策略」;whole-body RL 译「全身强化学习」;plant 保留控制论术语「被控对象」;performance envelope 译「性能包络」;testbed 译「试验台」;sim2real gap 译「仿真到真机的差距」。专名(人名、MuJoCo、Spot / Stretch / Atlas)保留原文。原文引号写法异常处不改动英文,中文按文意顺。
Atlas 装上轮子
在经典电机控制与全身强化学习之间架桥
本文由 Xiaoyu (Andy) Wu 撰写,他是 Atlas 团队的控制工程师。在波士顿动力及此前的工作里,他有十多年控制电动机与驱动它们的功率电子器件的经验。
¶1 如果给人形机器人装上轮子,再让一个学出来的控制器去开它,会发生什么?我们把 Atlas® 机器人 的脚换掉,就是为了弄明白这件事;这样能把我们的执行器,以及我们为执行器建的模型,逼到极限。
¶2 装轮子的 Atlas 不是一个产品,它是一台研究试验台。从 Spot 和 Stretch 多年积累的 客户使用数据 里我们知道:真实世界里的机器人常会遇到实验室无法完整复现的挑战;我们需要弄清机器人在极端工况下会怎么反应,并确保它在极限处依然可靠。和 Atlas 其它那些运动壮举 一样,我们得想办法去推这个极限。这个项目的目标,是看看一个学出来的全身控制器与真实执行器配合时能有多忠实——尤其是当执行器正跑在性能包络边缘的时候。
为什么用轮子?
¶3 我们想要这样一个场景:电机必须持续地同时输出高扭矩和高转速,并且全程带着真实负载。用轮子跑恰好完美符合:每一次起步、转向、刹停,都会把电机扫过它完整的扭矩-转速范围。
¶4 改装本身简单得出奇。只用一个定制适配器,把现成的滑板车轮圈装到我们原有的脚踝执行器上——这就是整台改装里唯一的新零件。因为 Atlas 从一开始就是按「可大批量生产、易维护」设计的,这次改造的工作量差不多等于给自行车换个轮子。
¶5 软件那侧同样直截了当。每个轮子只是被建模成一个「能连续旋转的脚踝」,所以我要做的,就是拿基线机器人模型,把脚换成轮子。
¶6 整个过程之轻松,到现在还让我惊讶。
¶7 我出身更偏「经典」电机控制,这是第一次真正扎进 强化学习。这是个向天天做 RL 的人学习的绝佳机会。除了把硬件逼到极限,我还想要一种直觉、跟手、开起来有意思的操控响应。
把层与层接起来
¶8 在 Atlas 这样的机器人上,执行器设计、底层电机控制、全身强化学习,各有各自钻研得很深的专家。这个项目让我得以在这些层之间的边界上工作。如果训练用的仿真把电机假定得过于理想,策略最后可能学到真硬件根本做不到的东西。如果仿真里的电机表现得和真电机一样,策略学到的动作就是机器人真能做出来的,而且有把握。
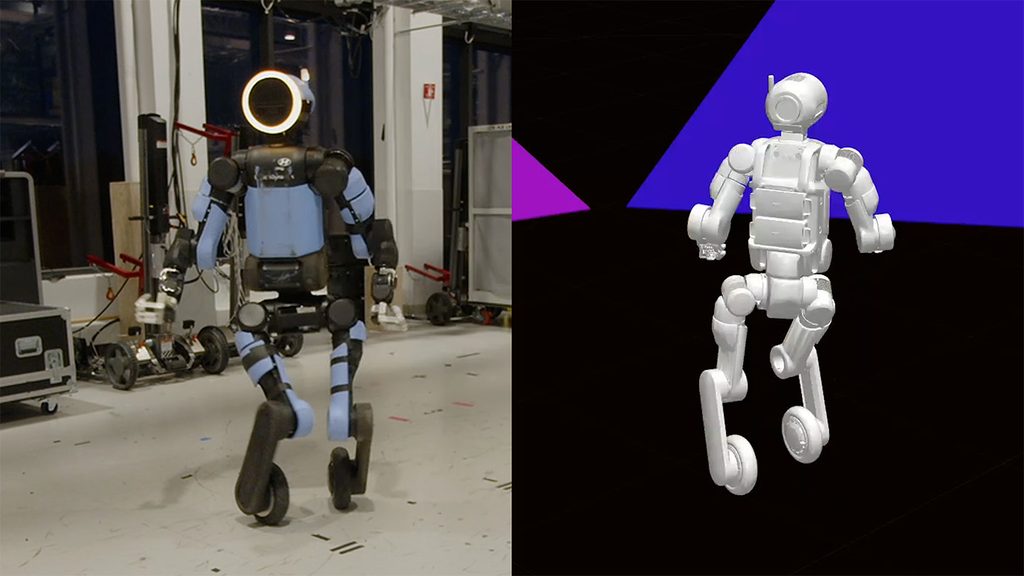
弥合仿真到真机的差距
¶9 先补个基础:强化学习的做法,是在机器人还没上真机之前,先跑上百万次仿真。但训练要有用,仿真里的机器人得映照出真实硬件。我们能让仿真电机表现得足够像现实里那台,好让仿真里训出来的策略迁移到物理机器人上吗?弥合这道仿真与硬件之间的差距(也叫 sim2real gap),才是真正的挑战,也正是这个项目成为重要学习平台的原因。
¶10 这份工作里相当一部分不光鲜但很重要:核对底层控制参数在每一套软件配置里都一致、跑特性标定实验、把仿真电机模型调到与真机实测吻合。同样重要的是判断哪些近似是安全的、哪些会被策略学会钻空子。目标是让策略训练时面对的「被控对象」,和它在硬件上遇到的是同一个。
¶11 转入 RL 意味着改造现成的策略框架,而不是从零开始。只对三处做了有针对性的改动——奖励组成、策略训练时指令的范围、以及它保持姿态的方式——平滑的滚动就自己涌现出来了,同时机器人保持稳定、好开。
¶12 跨这些层工作之后,我发现机器人的极限通常住在层与层之间:在电机、底层控制、训练三者如何互相影响里。能近距离看到这种相互作用、探索这块丰富的设计空间,是这个项目里我最喜欢的部分。
动作背后
¶13 有些动作来自一个人类动捕数据资料库。我专门挑了脚打滑多的片段,因为那看起来正是轮子会让事情变有意思的地方。确实如此!拿侧向冲刺来说:人会滑脚的地方,策略学会了转向轮子、直接滚过去。
¶14 360° 转体跳看着像高能量动作,其实风险很低。它是一个轨迹跟踪策略,跟着一段人做这个跳的记录走,而且第一次就成功了。有意思的是它使用抓地力的方式,和有脚的 Atlas 完全不同。比如起跳前「蓄势」那一下,下半身会快速滚到位,为向上的蹬发力做准备。
¶15 看着这些小技巧自己涌现出来,很迷人。给策略装上轮子,它自己就琢磨出该怎么用。
接下来
¶16 回头看,这个项目对我来说最棒的一点,是看到「懂电机」能把 RL 策略设计加速多少。造出这么一台开起来有意思的试验台,说明精确的电机模型与高层学习最好是搭在一起干的,而且彼此会让对方更好。
¶17 这些洞见已经在回流到我们的标准配置上。通过维持执行器动力学与全身 RL 之间的紧密整合,我们继续推高硬件极限、增强策略面对失效模式的鲁棒性,并扩展 Atlas 的能力包络。
在 Atlas 滚过真实地板之前,它先滚过了上百万块仿真地板。感谢让这个项目成真的所有人:感谢 Josh Geating 做了轮子适配器;感谢 Robin Deits、Shane Rozen-Levy、Roberto Shu,这套工作建立在他们做的 RL 栈之上;感谢技师 Mark Loughlin 和 Peter Jardin 把轮子拧到 Atlas 上;也感谢 Google DeepMind 的 Yuval Tassa 与 MuJoCo 团队提供了开源物理引擎。
译注与存疑
- ¶2 原文 "As Atlas' other athletic feats, we have to find ways to push the limits" 语法不完整(缺谓语),按上下文译作「和其它运动壮举一样,我们得想办法推极限」,属补全,标
[?]。 - ¶7 原文引号写作
“classical”‘,疑为排版错误,中文按「经典」处理,未改英文原文。 - ¶8 "with confidence" 译作「而且有把握」,指对策略动作可在真机复现的信心,不是「机器人有自信」。
- ¶10 plant 是控制论固定术语,指被控制的那个物理系统;这里特指仿真中的电机+传动模型。若按字面「工厂 / 设备」会读反。
- ¶14 windup 借棒球/高尔夫「引杆蓄力」,译「蓄势」;traction 译「抓地力」,与摩擦系数相关但不等同。
- ¶17 capability envelope 与 ¶2 performance envelope 是同一类「包络」说法,前者指整机能力边界、后者专指电机性能边界,译文保留区别。
- 结尾致谢两段斜体在原文被
*切成两段,属网页排版,中文合并为一段。 - 官方页面未显示发布日期;2026-11-09 为多家第三方一致口径,不是官方标注。